Hiểu Google
Robots.txt là gì? Mở tệp, đọc quy tắc và kiểm tra một URL
Th10
Mùa 4 — Chuyên đề 7/20: Kiến thức và thực hành SEO
Bài sản phẩm vẫn mở được. Khách vẫn xem ảnh, đọc mô tả, gửi yêu cầu bình thường. Nhưng khi kiểm tra URL, bạn gặp thông báo Google không được phép thu thập dữ liệu.
“Mình có khóa trang đâu?”
Anh Gồ chỉ vào một tờ hướng dẫn đặt ở cổng: người ghé thăm vẫn đi được, nhưng một số bot được yêu cầu đừng đi vào những lối nhất định. Trên website, tờ hướng dẫn ấy mang tên robots.txt.
Sau bài này, người đồng hành sẽ làm được: mở robots.txt của website, hiểu vài dòng thường gặp và biết cách kiểm tra một URL có đang bị chặn thu thập hay không. Buổi thực hành đầu tiên chỉ cần đọc và ghi nhận.
Robots.txt là gì, dùng để làm gì?
Robots.txt là tệp văn bản hướng dẫn các bot tuân thủ nó được hoặc không được thu thập những đường dẫn nào trên website. Chủ website có thể dùng tệp này để quản lý hoạt động thu thập dữ liệu, chẳng hạn hạn chế bot đi vào những khu vực không cần thu thập.
Tệp này không ngăn khách mở trang bằng trình duyệt và không thay thế việc đăng nhập, phân quyền. Cũng đừng xem nó là nút xóa một trang khỏi Google. Google giải thích công dụng và giới hạn của robots.txt.
Mở robots.txt của website ở đâu?
Thêm /robots.txt ngay sau tên miền và mở bằng trình duyệt. Ví dụ, bạn có thể xem robots.txt công khai của phamvanan.com. Đọc tệp này không cần vào trang quản trị.
- Mở một trang trên website mình muốn kiểm tra.
- Giữ phần giao thức và tên miền, bỏ đường dẫn bài viết phía sau.
- Thêm
/robots.txtrồi nhấn Enter. - Ghi địa chỉ vừa mở và lưu một bản nội dung để đối chiếu.
Chẳng hạn https://example.com/bai-viet/ sẽ dùng tệp https://example.com/robots.txt. Với tên miền phụ như shop.example.com, cần xem robots.txt của chính tên miền phụ đó; không mặc định lấy tệp ở tên miền chính. Vị trí đúng của robots.txt.
User-agent, Disallow, Allow và Sitemap nghĩa là gì?
Hãy đọc theo hai câu hỏi: nhóm này nói với bot nào, và áp dụng cho đường dẫn nào? Chưa cần học thuộc cả tệp.
Ví dụ dưới đây dùng để tập đọc cú pháp, không phải cấu hình đề nghị cài lên website:
User-agent: *
Disallow: /khu-vuc-mau/
Allow: /khu-vuc-mau/huong-dan.html
Sitemap: https://example.com/sitemap.xml| Dòng | Cách hiểu trong ví dụ |
|---|---|
User-agent: * |
Nhóm chung cho các bot áp dụng nhóm này; cần xem tệp có nhóm riêng cho bot đang xét không. |
Disallow: /khu-vuc-mau/ |
Yêu cầu không thu thập các đường dẫn bắt đầu bằng phần này. |
Allow: /khu-vuc-mau/huong-dan.html |
Cho phép đường dẫn cụ thể hơn này dù thư mục phía trên bị hạn chế. |
Sitemap: |
Chỉ vị trí tệp sitemap; không mở khóa các URL đang bị Disallow. |
Google xét nhóm phù hợp với bot và ưu tiên quy tắc khớp đường dẫn cụ thể hơn; không đơn giản là dòng nằm sau luôn thắng. Đường dẫn cũng phân biệt chữ hoa, chữ thường. Nếu gặp nhiều nhóm hoặc ký hiệu lạ, hãy giữ nguyên tệp và nhờ kiểm tra theo URL cụ thể. Quy tắc Google dùng để đọc robots.txt.
Nếu cần nhắc lại vai trò của danh sách URL, bạn có thể đọc bài sitemap trong Search Console.
Có ví dụ thật ngay trên website này không?
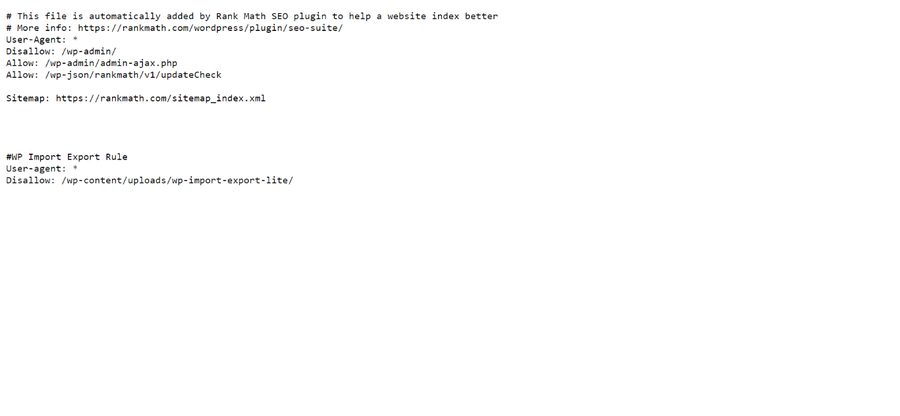
Có. Khi đối chiếu ngày 17/10/2026, robots.txt công khai của phamvanan.com có hai dòng liên tiếp:
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Hai dòng nằm trong nhóm chung User-agent: *: hạn chế thu thập khu vực quản trị, đồng thời cho phép đường dẫn cụ thể /wp-admin/admin-ajax.php. Đây là một đoạn trích; tệp còn các dòng khác, nên đừng lấy riêng đoạn này để kết luận toàn bộ website được phép hay bị chặn.
Tệp cũng có dòng Disallow: để trống trong một nhóm chung khác. Dòng trống ấy không có nghĩa mọi lệnh chặn ở trên đã bị xóa: Google kết hợp các nhóm áp dụng cùng user agent. Đây là lý do cần đọc cả tệp. Cách Google kết hợp nhóm quy tắc.
À… thấy chữ Disallow chưa đủ để nói website đang bị chặn. Mình còn phải xem nó đứng trong nhóm nào và chỉ vào đường dẫn nào.
Disallow: / có khác Disallow: để trống không?
Có, khác rất nhiều. Trong nhóm đang xét, Disallow: / là quy tắc chặn mọi đường dẫn, trừ những ngoại lệ phù hợp được cho phép. Còn Disallow: để trống không thêm đường dẫn bị chặn.
Nếu thấy dấu / ấy khi website vừa lên bản chính thức, hãy lưu lại nguyên văn nhóm quy tắc và gửi người phụ trách kiểm tra ngay. Không xóa cả tệp chỉ vì thấy một dòng đáng nghi. Ví dụ các cách viết quy tắc từ Google.
Chặn bằng robots.txt rồi, trang có biến mất khỏi Google không?
Không thể bảo đảm. URL vẫn có thể xuất hiện trên Google dù bot không thu thập được nội dung trang. Robots.txt kiểm soát việc ghé đọc, còn noindex kiểm soát việc lập chỉ mục.
Nếu vừa đặt noindex vừa chặn trang bằng robots.txt, Google có thể không vào được để đọc noindex. Muốn bảo vệ nội dung riêng tư thì cần biện pháp hạn chế truy cập phù hợp. Điều kiện để Google đọc và xử lý noindex.
Còn khi các URL chứa nội dung giống nhau và bạn muốn đề xuất một bản đại diện, hãy xem lại chuyên đề canonical trước khi chọn cách xử lý.
Làm sao kiểm tra một URL có bị robots.txt chặn không?
Trong Search Console, dùng Kiểm tra URL để xem khả năng thu thập của đúng trang cần kiểm tra. Nếu cần đối chiếu bản hiện tại, chạy kiểm tra URL đang hoạt động; dữ liệu lần Google ghi nhận trước đó có thể phản ánh cấu hình cũ.
- Chọn đúng tài sản của website trong Search Console.
- Dán đầy đủ URL bài viết hoặc sản phẩm đang quan tâm.
- Mở phần chi tiết thu thập dữ liệu, tìm mục cho biết có được phép thu thập hay không.
- Nếu kết quả cho biết bị robots.txt chặn, lưu URL, thông báo và thời điểm kiểm tra.
Được phép thu thập mới trả lời một phần câu hỏi; nó chưa bảo đảm trang sẽ được lập chỉ mục. Nếu chưa quen màn hình này, mở hướng dẫn đọc kết quả Kiểm tra URL. Tài liệu công cụ của Google.
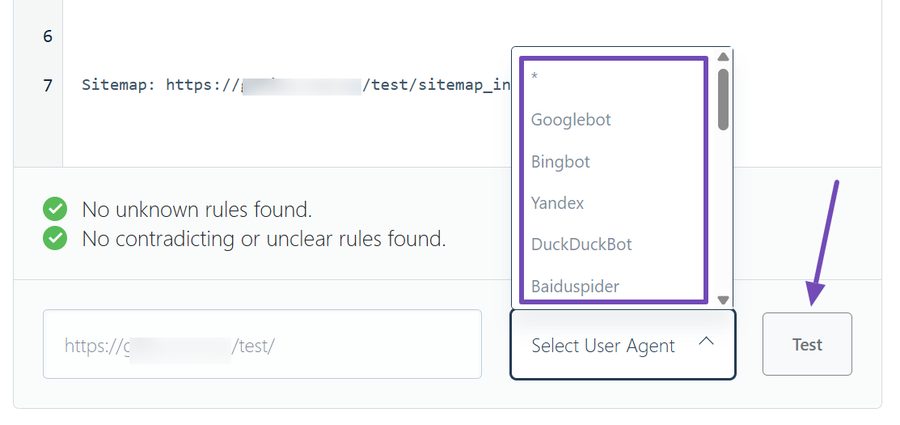
Một số công cụ còn cho thử một URL với user agent được chọn. Ảnh dưới là bộ kiểm tra trong Rank Math PRO: ô URL bên trái, bộ chọn bot ở giữa và nút Test bên phải. Chọn Googlebot khi muốn kiểm tra quy tắc áp dụng cho bot tìm kiếm web của Google; đừng chỉ thử dấu * nếu tệp có nhóm Googlebot riêng.
Search Console có báo cáo riêng về robots.txt không?
Có. Báo cáo robots.txt cho biết các tệp Google tìm thấy, thời điểm kiểm tra và vấn đề xử lý nếu có. Báo cáo này giúp đối chiếu bản Google đã lấy, còn trạng thái của một trang cụ thể vẫn cần xem bằng Kiểm tra URL.
Báo cáo hỗ trợ tài sản Miền và tài sản Tiền tố URL ở cấp gốc, không phải tài sản chỉ cho một thư mục con. Khi vừa sửa lỗi nghiêm trọng, báo cáo có chức năng yêu cầu thu thập lại tệp; thao tác đó không bảo đảm mọi URL vừa mở chặn sẽ được thu thập ngay. Hướng dẫn báo cáo robots.txt.
Nếu cần sửa robots.txt, bắt đầu từ đâu?
Lưu bản cũ và xác định nơi đang tạo ra tệp trước khi thay đổi. WordPress hoặc plugin có thể sinh robots.txt, nhưng máy chủ cũng có thể đang chứa một tệp thật.
Ví dụ, tài liệu Rank Math hướng dẫn mục Rank Math SEO → General Settings → Edit robots.txt trong Advanced Mode. Nếu một tệp thật đang được phục vụ ở thư mục gốc, thay đổi bản do plugin tạo có thể không có tác dụng. Đây là ví dụ cho website dùng Rank Math; không cần cài thêm plugin chỉ để làm bài thực hành đọc tệp này. Hướng dẫn chính thức của Rank Math.
Sau khi sửa đúng chỗ, mở lại địa chỉ robots.txt công khai và kiểm tra URL liên quan. Google có thể còn dùng bản lưu trong bộ nhớ đệm, nên ghi ngày sửa để đối chiếu. Google hướng dẫn cập nhật robots.txt.
Đừng chặn cả thư mục ảnh, CSS hoặc JavaScript chỉ để làm tệp trông “gọn”. Nếu các tài nguyên ấy cần để Google hiểu trang, việc chặn chúng có thể gây khó khăn cho quá trình phân tích. Lưu ý về tài nguyên trang.
Thực hành: mang về một kết quả kiểm tra
Hôm nay, hãy chọn một URL sản phẩm hoặc bài viết cần khách tìm thấy. Mở robots.txt và ghi theo mẫu:
Ngày xem: …
Địa chỉ robots.txt đã mở: …
URL cần kiểm tra: …
Nhóm bot và quy tắc có thể liên quan: …
Kết quả Kiểm tra URL, chép nguyên văn: …
Điều đã xác nhận / điều cần nhờ kiểm tra thêm: …
Nếu tệp trả về “không tìm thấy”, điều đó tự nó chưa phải lỗi SEO; website nhỏ có thể không cần tệp này. Nếu gặp lỗi máy chủ hoặc không tải được, gửi cả thông báo để người phụ trách xem xét, thay vì đoán website đã bị Google chặn. Giải thích thêm của Google về robots.txt.
Kết quả buổi này có thể chỉ là: “URL mình cần không bị robots.txt chặn.” Như vậy đã có ích — mình biết không cần sửa nhầm tệp này khi tìm nguyên nhân trang chưa xuất hiện trên Google.
Chuyên đề tiếp theo: chuyển hướng 301
Khi một bài viết hoặc sản phẩm chuyển sang địa chỉ mới, làm sao để khách bấm đường dẫn cũ vẫn đến đúng nơi? Chuyên đề 8 sẽ cùng tìm hiểu chuyển hướng 301, cách kiểm tra và những trường hợp không nên chuyển hướng tùy tiện.
← Bài trước: Canonical là gì? · Các chuyên đề Mùa 4 · Bản đồ Hiểu Google
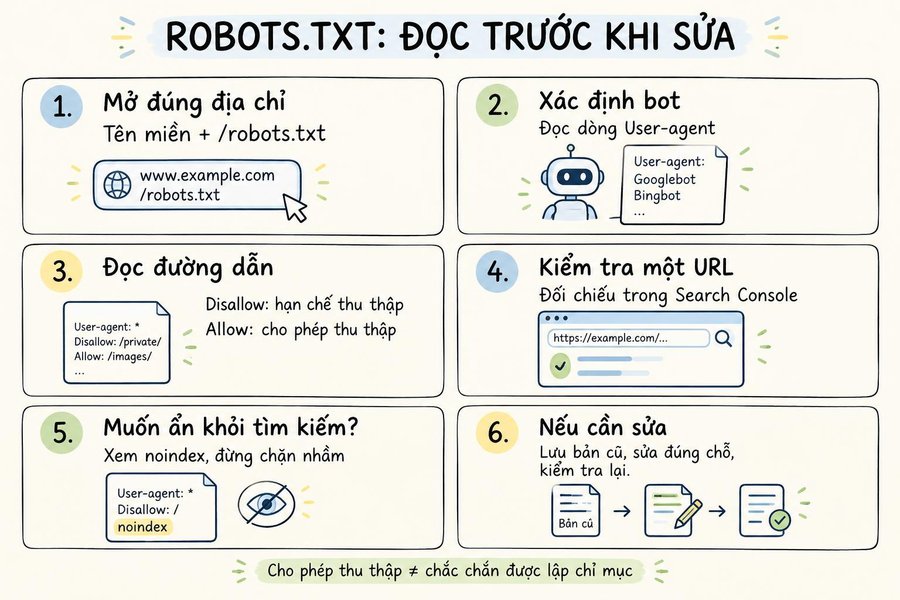
Đối chiếu tài liệu và robots.txt công khai của phamvanan.com ngày 17/10/2026; không thay đổi cấu hình website và chưa kiểm tra dữ liệu Search Console riêng. Ảnh giao diện từ tài liệu Rank Math, có nguồn dưới hình; ảnh đại diện là thiết kế minh họa riêng cho Hiểu Google. Sketchnote cuối bài là hình tổng kết minh họa.
Sketchnote: một hình để nhớ khi quay lại